Вернуться к блогу
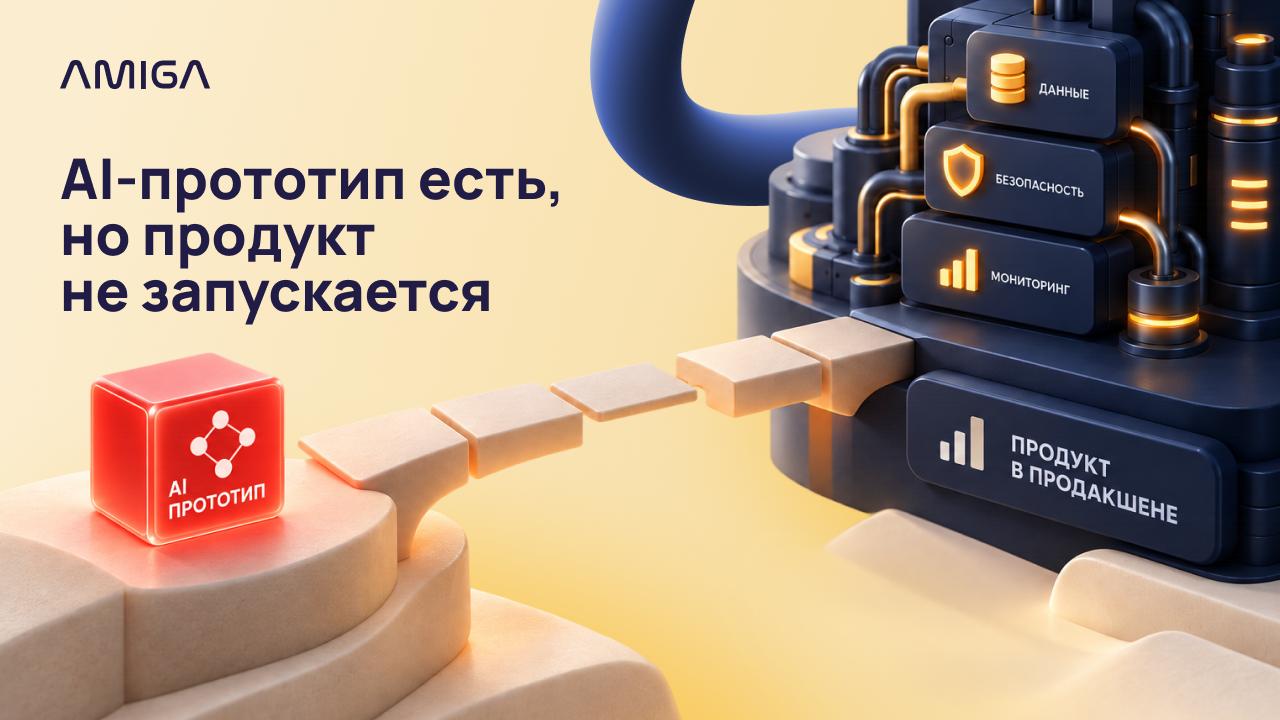
AI-прототип может уверенно отвечать на тестовые вопросы, распознавать документы или выполнять нужные действия во время презентации. Но между удачным демо и запуском для реальных пользователей остается большой разрыв.
На тестовых данных все выглядит убедительно. В рабочей среде появляются неполные запросы, противоречивые документы, ограничения доступа, ошибки интеграций и ситуации, которых не было в подготовленном сценарии. Одновременно возникает вопрос: кто отвечает за результат, если система ошиблась?
Поэтому после демонстрации важно проверять не только качество модели. Нужно понять, решает ли прототип конкретную задачу, встроен ли он в бизнес-процесс и можно ли безопасно поддерживать его после запуска.
Ниже – диагностика для компаний, у которых AI-демо уже есть, но решение все еще не готово к промышленной эксплуатации.
Чаще всего проблема находится не в самой модели. Выход в прод останавливают неподготовленные данные, размытые критерии качества, отсутствие интеграций или непонятная ответственность за работу системы.
Симптом | Возможная причина | Что проверить | Следующий шаг |
Демо производит впечатление, но непонятно, какую пользу даст бизнесу | Нет измеримой пользовательской задачи | Кто будет пользоваться решением, какое действие изменится, какой показатель должен улучшиться | Зафиксировать сценарий, текущую точку и целевую метрику |
Ответы на тестах хорошие, а на реальных примерах качество падает | Данные неполные, устаревшие или недоступны | Источники, структуру, актуальность, права доступа, долю пропусков и ошибок | Провести аудит данных и подготовить эталонную выборку |
Прототип работает только при участии его автора | Решение не встроено в реальный процесс | Откуда приходит запрос, куда передается результат, какие действия выполняются вручную | Описать целевой процесс и автоматизировать критические переходы |
Нельзя однозначно сказать, хорошо ли работает AI | Нет критериев качества и приемки | Точность, полноту, допустимую долю ошибок, задержку ответа, правила проверки | Сформировать набор тестов и пороговые значения |
Служба безопасности не согласовывает запуск | Не продуманы доступы, хранение данных и внешние сервисы | Какие сведения передаются модели, где хранятся логи, кто видит результаты | Спроектировать контур безопасности и модель доступа |
После сбоя никто не понимает, что произошло | Нет мониторинга и ответственного | Какие события фиксируются, кто получает уведомления, можно ли восстановить ход запроса | Настроить журналирование, уведомления и регламент реакции |
Прототип дорабатывают месяцами без решения о запуске | Нет точки принятия решения | Какие результаты достаточны для пилота, когда гипотезу нужно пересмотреть или закрыть | Назначить срок проверки и критерии перехода к следующему этапу |
Эта таблица помогает определить, где именно проект остановился. Дальше разберем каждую причину подробнее.
Фраза «хотим внедрить AI» не объясняет, что должно измениться для пользователя или компании.
Допустим, команда создала помощника для работы с внутренними документами. Он отвечает на вопросы сотрудников, но этого недостаточно для оценки результата. Нужно определить, какую задачу он решает:
После этого появляется измеримый ориентир. Например, раньше сотрудник искал ответ 15 минут, а с новым инструментом должен находить его за две. Или половина типовых запросов должна обрабатываться без участия специалиста.
Без такой метрики прототип оценивают по субъективному впечатлению: «отвечает неплохо» или «демо выглядит интересно». Этого недостаточно, чтобы обосновать внедрение.
Начинать стоит с одного основного сценария. Если он показывает результат, область применения можно расширять. Такой подход помогает не превращать пилот в попытку сразу автоматизировать весь процесс.
На демонстрации прототип часто получает заранее подобранные документы и понятные запросы. В рабочей системе данные выглядят иначе: часть файлов устарела, названия не совпадают, документы дублируются, а важная информация хранится в письмах или таблицах сотрудников.
В результате AI дает слабый ответ не потому, что выбрана неподходящая модель. У него нет надежной основы для работы.
Перед запуском нужно разобраться:
Для поиска по корпоративной базе знаний также важно проверить структуру документов, качество разбиения текста и правила выбора контекста. Подробнее о работе моделей с информацией мы рассказывали в статье «Что такое LLM».
Результатом аудита должна стать не абстрактная оценка данных, а перечень конкретных ограничений: какие источники готовы к подключению, какие требуют очистки и какие пока нельзя использовать.
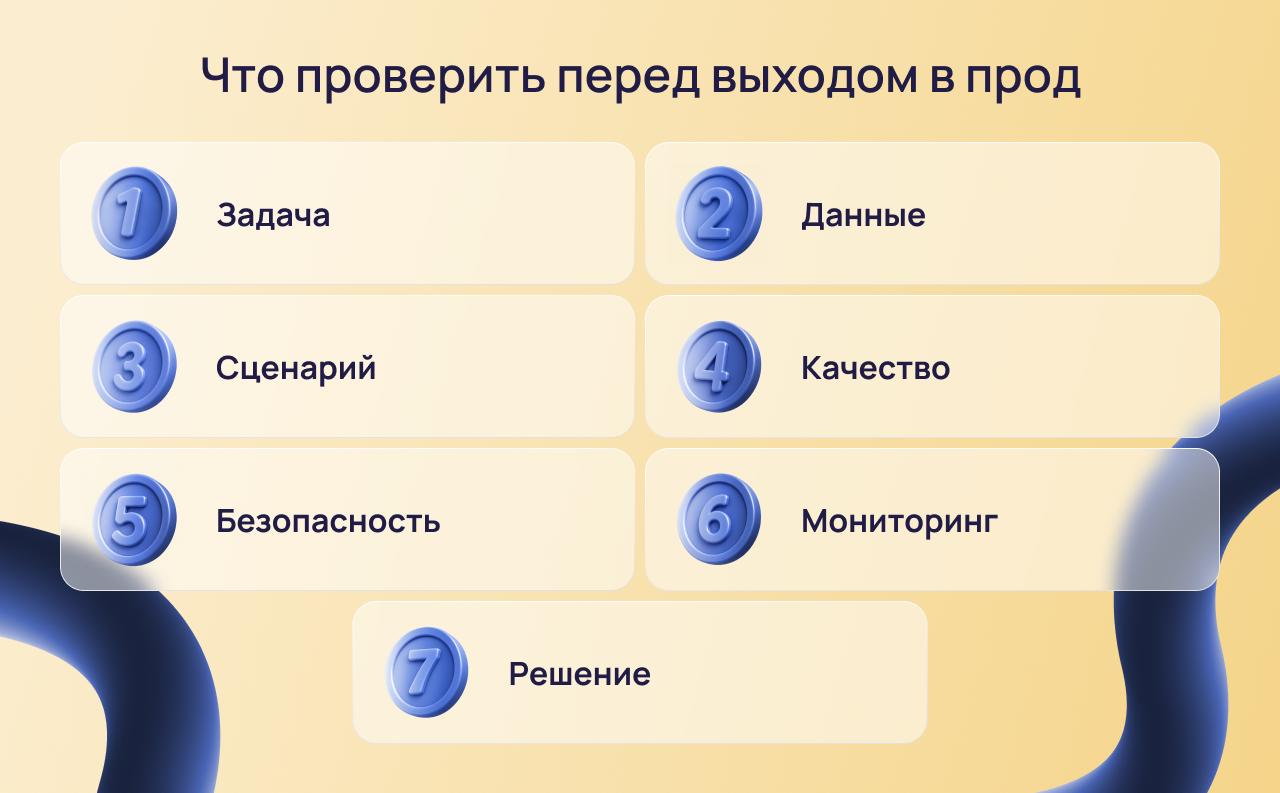
Разрозненные документы проходят очистку и проверку перед загрузкой в базу данных и использованием AI-системой.
Во время демо пользователь вводит запрос в отдельное окно и получает ответ. В реальной работе результат часто приходится переносить в CRM, ERP, систему документооборота или административную панель.
Если сотрудник копирует данные вручную, проверяет их в нескольких сервисах и только потом выполняет действие, AI остается вспомогательным инструментом. Он не становится частью процесса.
Чтобы найти разрыв, полезно пройти весь сценарий:
Например, недостаточно научить модель классифицировать обращения клиентов. Нужно определить, как обращение попадет на анализ, куда уйдет после классификации и что произойдет, если система не уверена в ответе.
На этом этапе особенно важна системная аналитика. Она помогает описать участников процесса, связи между сервисами, правила передачи данных и исключительные ситуации до того, как команда начнет расширять прототип.
AI-модуль встроен в рабочий процесс и связан с клиентскими данными, складом, документами, правами доступа и мониторингом.
Фраза «AI отвечает правильно в большинстве случаев» ничего не говорит о готовности к запуску. Для одного сценария допустима ошибка в каждом десятом ответе, для другого даже один неверный результат создает финансовый или юридический риск.
Критерии зависят от задачи. Для поиска по документам важны полнота ответа и корректность источников. Для классификации – доля верно определенных категорий. Для распознавания – точность извлечения ключевых полей. Для AI-агента – правильность всей последовательности действий.
Одной общей цифры обычно недостаточно. Нужны отдельные проверки для типовых, сложных и критичных случаев.
Что оцениваем | Пример критерия |
Качество результата | Не менее 90% корректных ответов на эталонной выборке |
Подтверждение источника | Каждый фактический ответ содержит ссылку на документ |
Скорость | Ответ формируется не дольше установленного времени |
Неопределенность | При нехватке данных система не придумывает ответ, а сообщает об ограничении |
Критичные ошибки | Опасные действия всегда требуют подтверждения человека |
Стабильность | Повторные запросы не приводят к принципиально разным результатам без причины |
Отдельно нужно определить поведение при сбое. Пользователь должен понимать, что произошло и что делать дальше. В критичных операциях нужен безопасный запасной сценарий: передача задачи сотруднику, повторный запрос или возврат к обычному процессу.
Ошибки и неточные ответы нельзя исключить полностью. В статье о будущем LLM мы подробнее разбирали, почему контроль источников и внешняя проверка становятся частью архитектуры AI-систем.
Прототип часто подключают к модели напрямую. Для теста этого достаточно. В рабочем решении появляются дополнительные требования:
Особенно важно проверить, не получает ли AI больше данных, чем требуется для конкретной задачи. Если сотруднику разрешено видеть только часть клиентской базы, интеллектуальный помощник не должен обходить это ограничение.
Еще один вопрос – стоимость эксплуатации. Расходы зависят не только от цены одного запроса. На них влияют объем контекста, количество обращений, повторные попытки, хранение истории, инфраструктура поиска и работа дополнительных сервисов.
Полезно посчитать стоимость не одного идеального ответа, а полноценной операции. Например, обработка документа может включать распознавание, извлечение данных, проверку, обращение к модели и запись результата в учетную систему.
Так становится понятно, остается ли решение экономически оправданным при росте нагрузки.
Обычное приложение обычно либо выполняет операцию, либо возвращает ошибку. AI-система может формально отработать успешно, но выдать слабый или некорректный результат. Поэтому технического мониторинга доступности недостаточно.
После запуска нужно видеть:
Также необходим владелец процесса. Он отвечает не за обучение модели как таковое, а за итоговый результат: рассматривает спорные случаи, следит за метриками и принимает решение о корректировке сценария.
Для серьезных сбоев нужен регламент. В нем фиксируют, кто получает уведомление, когда отключается автоматическое действие, как переключиться на ручную обработку и какие данные потребуются для расследования.
Если такой порядок не определен, пилот может работать только пока рядом находится разработчик, который знает его внутреннее устройство.
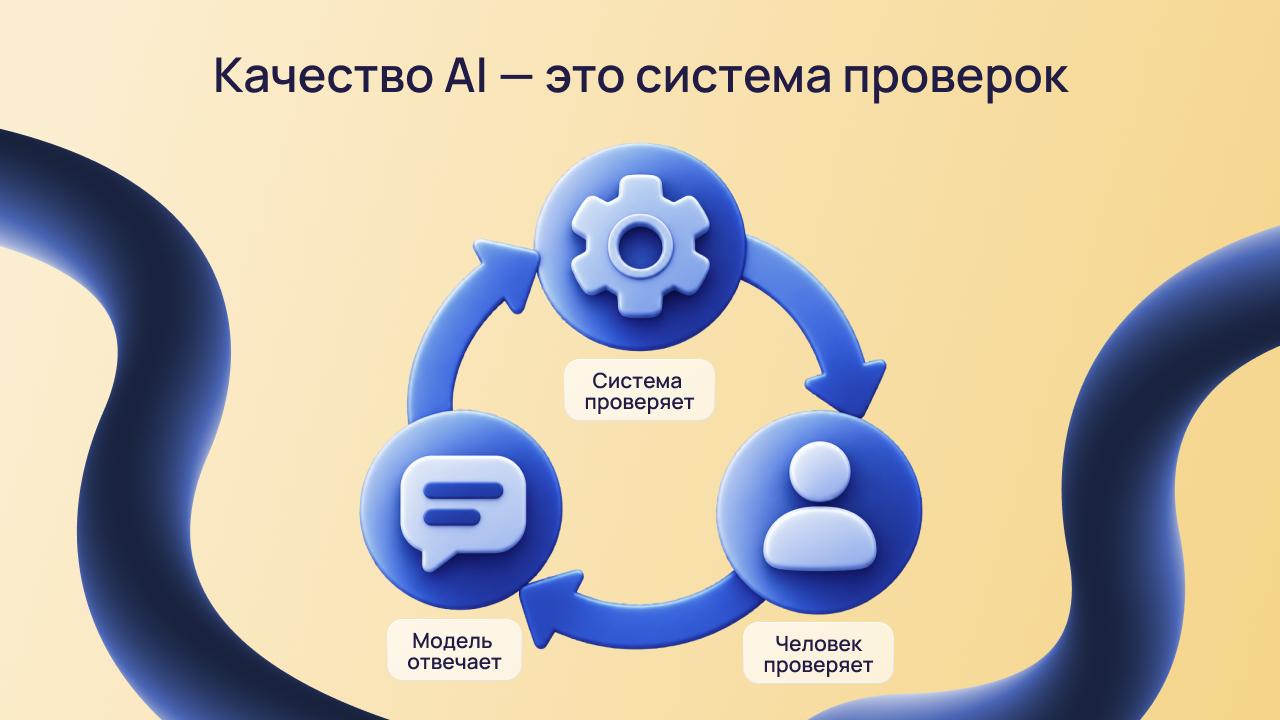
Ответ AI проходит автоматическую проверку и подтверждение человеком, а ошибки направляются на ручную обработку и фиксируются в мониторинге.
Некоторые AI-прототипы месяцами остаются в промежуточном состоянии. Их продолжают улучшать, хотя команда не понимает, приблизилась ли система к запуску.
Чтобы выйти из этого цикла, заранее задают срок проверки и критерии решения.
Пилот оправдан, если основной сценарий работает на реальных данных, риски ограничены, а результат можно измерить. Первую версию лучше открыть небольшой группе пользователей и сохранить ручную проверку критичных действий.
Доработка нужна, когда ценность подтверждена, но обнаружен конкретный технический разрыв: не хватает интеграции, требуется очистка данных или качество не достигает согласованного порога.
Важно, чтобы у этого этапа был понятный результат. Формулировка «еще улучшить ответы» слишком размыта. Лучше зафиксировать: повысить точность классификации с 75 до 90% или сократить ручную обработку до 20% обращений.
Закрытие прототипа – не обязательно неудача. Если проверка показала, что задача решается обычной автоматизацией дешевле и надежнее, эксперимент уже принес пользу.
Гипотезу также стоит пересмотреть, если нет доступных данных, стоимость операции превышает эффект или ошибки создают неприемлемый риск.
Главное – принимать решение по результатам проверки, а не продолжать разработку только потому, что в прототип уже вложены ресурсы.
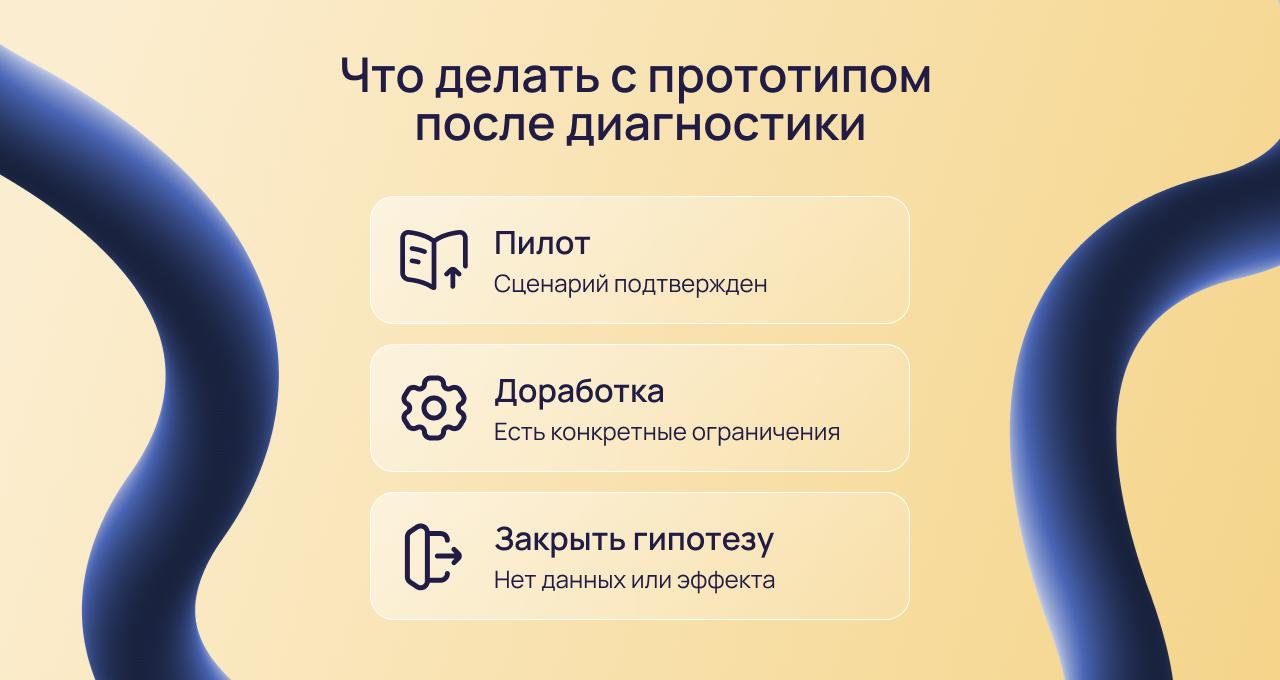
После диагностики команда выбирает один из трех вариантов: ограниченный пилот, доработка решения или закрытие гипотезы с фиксацией выводов.
Для первичной оценки не требуется сразу переписывать решение. Достаточно последовательно проверить четыре уровня.
Первый – бизнес. Какую задачу решает система, кто получает пользу и по какой метрике ее можно подтвердить?
Второй – пользовательский сценарий. Где появляется запрос, как человек получает результат и что происходит при ошибке?
Третий – данные и архитектура. Откуда поступает информация, какие интеграции нужны и как устроены права доступа?
Четвертый – эксплуатация. Кто следит за качеством, сколько стоит работа решения и как команда реагирует на сбои?
По итогам диагностики должен появиться не список общих рисков, а план действий с приоритетами и ответственными.
Решение | Когда подходит | Что делать дальше |
Запустить ограниченный пилот | Сценарий и метрика понятны, риски контролируются | Выбрать группу пользователей, настроить мониторинг, сохранить ручную проверку |
Доработать прототип | Ценность подтверждена, но есть конкретные технические ограничения | Подготовить данные, реализовать интеграции, провести тестирование |
Изменить сценарий | AI работает, но не решает исходную задачу | Уточнить пользовательский путь и найти участок процесса с измеримым эффектом |
Закрыть гипотезу | Нет данных, экономического эффекта или приемлемого уровня риска | Зафиксировать выводы и рассмотреть обычную автоматизацию |
Демонстрация обычно проходит на подготовленных данных и по заранее известному сценарию. В реальной эксплуатации появляются нестандартные запросы, ограничения доступа, ошибки интеграций и требования к безопасности, мониторингу и ответственности.
Прототип подтверждает, что идея технически осуществима. Готовый продукт должен стабильно работать на реальных данных, быть встроен в бизнес-процесс, соблюдать права доступа и корректно обрабатывать ошибки.
У него должен быть ограниченный пользовательский сценарий, измеримая метрика, проверенное качество, понятные риски и ответственный за результат. Критичные операции на этапе пилота лучше оставлять под контролем человека.
Нужна выборка, отражающая реальную эксплуатацию: типовые, редкие, ошибочные и пограничные запросы. Подготовленные исключительно для демонстрации примеры не позволяют объективно оценить качество.
Нет. Задача команды – определить допустимый уровень ошибок, ограничить последствия, настроить проверку и предусмотреть безопасный сценарий для ситуаций, в которых система не уверена в результате.
Когда для нее нет надежных данных, стоимость эксплуатации выше ожидаемого эффекта, риски нельзя контролировать или обычная автоматизация решает задачу проще и надежнее.
У решения должен быть владелец со стороны бизнеса или продукта. Он следит за метриками, рассматривает спорные случаи и вместе с технической командой принимает решения о доработке системы.
В Amiga мы начинаем не с замены модели и не с расширения списка функций. Сначала разбираем, где находится реальное ограничение: в пользовательском сценарии, данных, интеграциях, архитектуре или эксплуатации.
Команда системной аналитики описывает текущий процесс, роли, источники информации и требования к результату. Разработчики оценивают интеграции и технический контур. QA помогает сформировать проверяемые критерии качества, а продуктовая команда связывает работу решения с бизнес-метрикой.
После такой диагностики становится понятно, что делать с прототипом дальше: подготовить ограниченный пилот, составить план доработки или отказаться от гипотезы до того, как она потребует новых затрат.
Перед запуском проверьте:
Если на несколько пунктов пока нет ответа, проекту нужна не новая функция, а диагностика.